Para aparecer en Perplexity necesitas permitir a PerplexityBot en tu archivo robots.txt, redactar cada sección con una respuesta autónoma de una a tres frases que conteste directamente el encabezado, y añadir marcado schema de tipo FAQPage o Article con fechas verificables. Sin estos tres elementos, el motor no puede rastrear, verificar ni citar tu contenido con garantías.
En resumen:
- Redacta cada sección como respuesta autónoma de una a tres frases, con la respuesta al principio, datos verificables, fuentes primarias y marcado FAQPage o Article.
- Autoriza a PerplexityBot en robots.txt y espera hasta 24 horas para comprobar los cambios, pues su propagación puede demorarse ese tiempo.
- Distingue PerplexityBot de Perplexity-User, cuyas peticiones puntuales pueden seguir reglas distintas; configura el cortafuegos con IP oficiales y confirma respuestas 200 OK en los registros.
- Comprueba consultas relevantes cada semana, registra los dominios citados y mide por separado el tráfico referido y los clics procedentes de Perplexity.
- Las primeras citas pueden llegar en días o semanas; tras los ajustes de contenido y marcado estructurado, su presencia suele estabilizarse entre dos y cuatro semanas.
Tabla de contenidos
- Señales y formato de contenido que aumentan la probabilidad de cita
- Requisitos técnicos: robots.txt, WAF y control de acceso por IP
- Cómo comprobar si Perplexity ya cita tus páginas
- Nuestro enfoque por fases para conseguir citas en Perplexity
- Lo que de verdad importa al optimizar para Perplexity
- Cómo te ayudamos a que Perplexity cite tu web
- Preguntas frecuentes
- Fuentes
Señales y formato de contenido que aumentan la probabilidad de cita
Perplexity extrae pasajes cortos, no artículos completos. Esto cambia la forma de escribir: cada sección debe funcionar como una unidad independiente que responda el encabezado sin necesitar el párrafo anterior ni el siguiente.
La estructura que mejor funciona sigue un patrón simple: abre con la respuesta en una a tres frases, añade después el contexto, los matices y los enlaces a fuentes primarias. Las cifras y fechas concretas refuerzan la verificabilidad, algo que la EDPB señala como un factor relevante en sus recomendaciones sobre minimización de datos y validación de contenido usado por sistemas de inteligencia artificial: cuanto más fácil es comprobar un dato, menor es el riesgo de que un agente lo descarte.
El marcado estructurado complementa el texto. El tipo Schema es el vocabulario estándar para preguntas y respuestas, y facilita que un indexador identifique qué fragmento responde qué pregunta sin ambigüedad. Para artículos informativos, el tipo Article cumple una función equivalente al declarar fecha de publicación, autor y tema principal.
Algunas prácticas concretas que marcan la diferencia:
- Escribe la respuesta antes de la explicación, nunca al final del párrafo.
- Incluye fechas, cifras y nombres propios que permitan comprobar el dato en origen.
- Enlaza fuentes primarias dentro del propio texto, no solo en una lista final.
- Marca preguntas frecuentes con
FAQPagey artículos informativos conArticle. - Evita jerga ambigua: una frase que admite dos lecturas rara vez se cita.
Consejo profesional: redacta cada subtítulo como si fuera a aparecer solo, sin el resto del artículo alrededor: así compruebas si realmente contesta por sí mismo.
Requisitos técnicos: robots.txt, WAF y control de acceso por IP
Antes de trabajar el contenido, hay que garantizar que los rastreadores pueden entrar. Sigue este orden:
- Añade una regla explícita que permita
User-agent: PerplexityBoten tu robots.txt, ya que Perplexity exige esa autorización expresa y los cambios pueden tardar hasta 24 horas en propagarse. - Revisa si tu configuración de seguridad distingue entre
PerplexityBot, que respeta robots.txt, yPerplexity-User, cuyas peticiones activadas por usuarios pueden comportarse de forma distinta ante esas mismas directivas, según detalla el centro de ayuda de Perplexity. - Configura reglas de WAF que combinen verificación de User-Agent con el rango de IP publicado en el endpoint
.jsonoficial de Perplexity, en lugar de fiarte solo de la cabecera del navegador. - Revisa logs del servidor para confirmar respuestas
200 OKdesde esas IPs y detectar bloqueos accidentales por reglas de seguridad demasiado estrictas.
El dato clave: Perplexity puede tardar hasta 24 horas en procesar un cambio de robots.txt, así que cualquier comprobación de acceso debe esperar ese margen antes de concluir que algo falla.
Cómo comprobar si Perplexity ya cita tus páginas
La forma más directa de saberlo es hacer preguntas reales en Perplexity sobre tu sector y revisar las citas numeradas que acompañan la respuesta: si tu dominio aparece, ya estás dentro del circuito de confianza del motor.
Más allá de la comprobación manual, conviene sistematizar el seguimiento:
- Repite búsquedas relevantes cada semana y anota qué dominios aparecen citados junto al tuyo.
- Revisa el tráfico referido en tu analítica para detectar picos que coincidan con nuevas citas.
- Mide el CTR desde Perplexity por separado de otras fuentes de tráfico para entender su peso real.
- Cuenta cuántas veces se menciona tu dominio en respuestas distintas, no solo en una.
Las primeras citas suelen aparecer en días o semanas tras abrir el acceso al rastreador; la estabilización, tras ajustar contenido y schema, suele tardar entre dos y cuatro semanas en reflejarse de forma consistente.
Nuestro enfoque por fases para conseguir citas en Perplexity
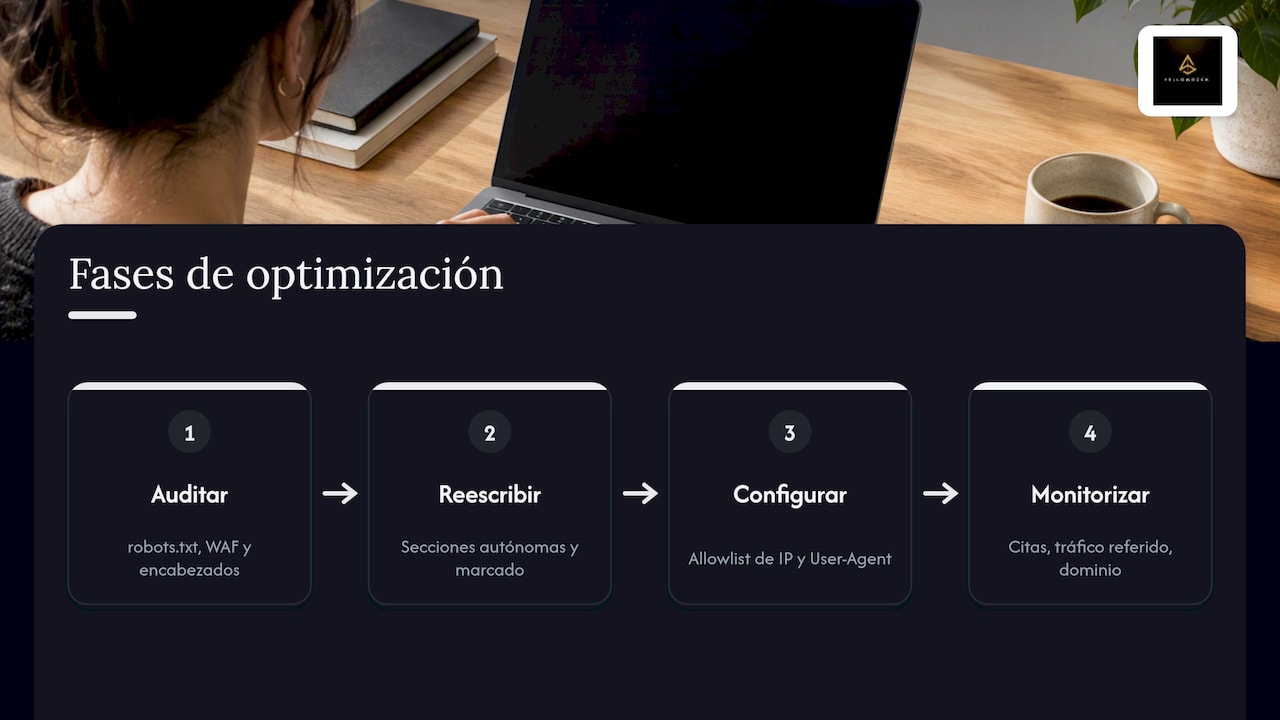
Trabajamos la visibilidad en motores de inteligencia artificial como una fase más dentro del posicionamiento general de un negocio local, no como un proyecto aislado. El proceso empieza con una auditoría técnica que revisa robots.txt, reglas de WAF y la estructura de encabezados existente.
A partir de ahí reescribimos las secciones críticas para que cada una conteste de forma autónoma, añadimos el marcado FAQPage o Article donde corresponde y configuramos el allowlist de IP y User-Agent cuando el hosting lo permite. La fase final es de monitorización continua: comprobamos citas, tráfico referido y evolución del dominio en respuestas de Perplexity, y lo incluimos en los informes mensuales que ya entregamos sobre posicionamiento en Google y Google Maps.
Lo que de verdad importa al optimizar para Perplexity
La mayoría de las guías sobre este tema se centran en el aspecto técnico, el robots.txt, las reglas de WAF, el endpoint de IPs, y lo tratan como si fuera el problema principal. No lo es. Abrir el acceso a PerplexityBot es un paso de una tarde; conseguir que el contenido merezca ser citado es el trabajo real y continuo.
El error más común que vemos es tratar el SEO para IA como una capa añadida al final, un schema que se pega sobre un texto que ya estaba escrito para otro propósito. Funciona mejor al revés: escribir cada sección como si tuviera que sobrevivir sola, fuera de contexto, delante de alguien que solo verá esas tres frases. Eso obliga a pensar primero en la respuesta y después en el argumento, que es exactamente lo contrario de como se enseña a escribir contenido web tradicional.
Si solo puedes priorizar una cosa, que sea esa: la claridad estructural de cada párrafo, antes que cualquier ajuste de configuración.
— YellowRock
Cómo te ayudamos a que Perplexity cite tu web
Conseguir que un negocio local aparezca citado en Perplexity exige combinar ajustes técnicos con una reescritura de contenido que pocas agencias dominan a la vez. Integramos ambas capas dentro del mismo plan de posicionamiento, junto con la optimización que ya trabajamos para Google y Google Maps.
Nuestro servicio incluye:
- Auditoría técnica de robots.txt, WAF y accesibilidad para rastreadores de IA.
- Reescritura de secciones clave para que cada una funcione como respuesta extraíble.
- Configuración de allowlist por IP y User-Agent cuando el hosting lo permite.
- Monitorización mensual de citas, tráfico referido y evolución del dominio.
Si prefieres un soporte más automatizado para marcado estructurado y publicación continua, BabyLoveGrowth ofrece herramientas orientadas a ese tipo de tareas técnicas. Nuestra propuesta sigue un camino distinto: integramos en un solo sistema el SEO web, Google Maps, los algoritmos de inteligencia artificial y la gestión de reputación, con reportes verificables cada mes y atención directa a cada cliente.
Si quieres que revisemos el estado actual de tu web frente a Perplexity, puedes empezar con el plan Crecimiento Inteligente, desde 99 € al mes, o consultar el resto de servicios disponibles.
Preguntas frecuentes
¿Qué es PerplexityBot y qué hace exactamente?
PerplexityBot es el rastreador que indexa contenido de forma continua para que Perplexity pueda citarlo después en respuestas. Respeta las directivas de robots.txt y requiere permiso explícito para acceder a una web.
¿Cuánto tarda Perplexity en reflejar un cambio en robots.txt?
Los cambios en robots.txt pueden tardar hasta 24 horas en propagarse en los sistemas de Perplexity. Conviene esperar ese margen antes de comprobar si el acceso ya funciona.
¿Qué diferencia hay entre PerplexityBot y Perplexity-User?
PerplexityBot rastrea e indexa contenido de forma regular, mientras que Perplexity-User ejecuta peticiones puntuales activadas cuando alguien hace una pregunta que requiere datos frescos de una web concreta. El centro de ayuda de Perplexity explica que ambos pueden comportarse de forma distinta frente a robots.txt.
¿Es importante el schema FAQPage para aparecer en Perplexity?
Sí, el marcado FAQPage de schema.org es el vocabulario estándar para estructurar preguntas y respuestas, lo que facilita que un sistema de IA identifique y extraiga el fragmento correcto. Combinarlo con respuestas autónomas de una a tres frases mejora la probabilidad de cita.
¿Qué errores bloquean la aparición de una web en Perplexity?
Los más comunes son no permitir PerplexityBot en robots.txt, bloquear el acceso por reglas de WAF mal configuradas y escribir contenido que depende del párrafo anterior para tener sentido. Revisar logs del servidor y hacer pruebas de acceso periódicas ayuda a detectar estos problemas a tiempo.
Fuentes
Perplexity no es un buscador tradicional: combina un rastreo regular de páginas con peticiones puntuales que se activan cuando una persona hace una consulta que requiere información fresca de un dominio concreto. Por eso documenta dos user agents distintos: PerplexityBot, que indexa contenido de forma continua, y Perplexity-User, que ejecuta peticiones en tiempo real cuando alguien pregunta algo que exige consultar una web específica.
A diferencia de muchos resultados de búsqueda convencionales, Perplexity siempre muestra la fuente junto a la respuesta, con un número de cita visible y clicable. Esa cita no es un enlace cualquiera: genera tráfico de calidad porque llega a alguien que ya leyó un resumen fiable de tu contenido y decide profundizar. Para un negocio local, aparecer citado equivale a una validación de autoridad que compite directamente con el tráfico que antes solo venía de Google.